「SDXLとは何で、2026年のいまも選ぶ意味があるのでしょうか?」
SDXL(Stable Diffusion XL)は、Stability AIが2023年7月26日に公開した画像生成モデルで、2026年9月26日時点でも公式のBase 1.0とRefiner 1.0を入手して動かせますが、同社の現行カタログでは旧世代の「legacy base model」と位置づけられています。
検索への直答
- 何が特徴か:ネイティブ1024×1024、2つのテキストエンコーダー、Base+任意のRefinerという構成です。
- どう使うか:公式Hugging Faceから重みを取得し、DiffusersでBase単体またはBase+Refinerを実行できます。
- 商用利用できるか:SDXL 1.0のCreativeML Open RAIL++-M Licenseは商用利用を一律禁止していません。ただし、禁止用途、再配布、派生モデル、入力素材、生成物の第三者権利を別々に確認する必要があります。
- いま選ぶべきか:既存のSDXL資産を生かしてセルフホストしたい場合は候補です。新規案件では、Stable Image Core、Stable Diffusion 3.5、Stable Image Ultraも同じ条件で比較してください。
Stability AIとHugging Faceの当日取得情報を基準に、仕組み、公式の動かし方、商用利用の判断点、現行モデルとの関係を順番に整理します。第三者Web UIや非公式のインストールコマンドは手順に含めていません。
SDXLとは何を指すのか
SDXLは「Stable Diffusion XL」の略称です。Stability AIのSDXL 1.0公式発表によると、正式版は2023年7月26日に公開されました。テキストから画像を生成する潜在拡散モデルで、公式モデルカードは画像生成だけでなく、テキスト指示に基づく画像変更にも使えると説明しています。
「XL」は単に出力サイズが大きいという意味だけではありません。SDXL技術報告では、従来版より約3倍大きいUNet、2つ目のテキストエンコーダー、画像サイズと切り抜き位置を条件として与える仕組み、複数アスペクト比での学習、仕上げ用Refinerが主要な変更点として示されています。
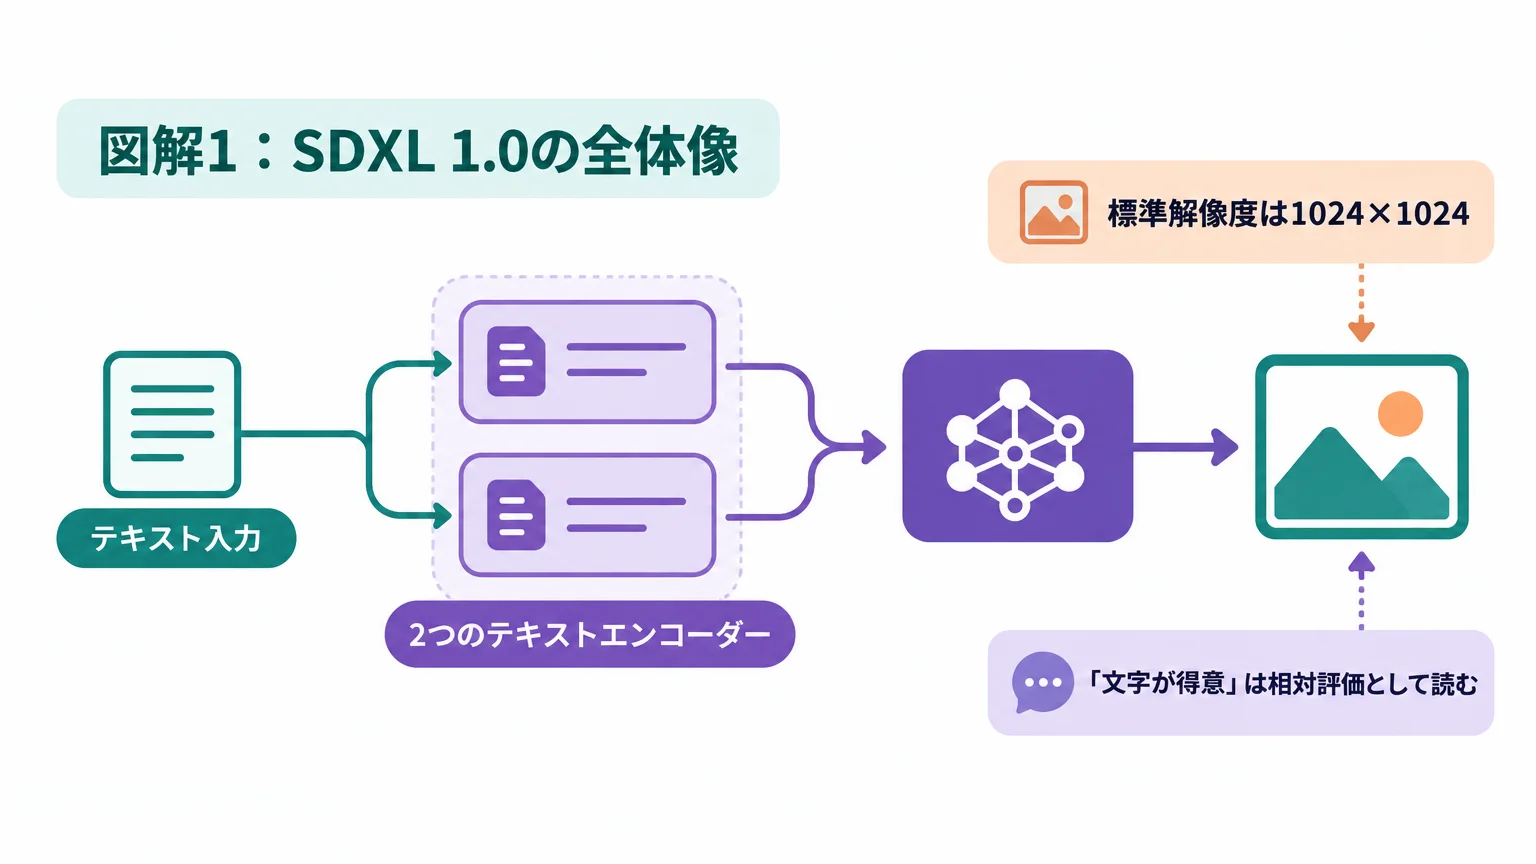
標準解像度は1024×1024
公式発表はSDXL 1.0のネイティブ解像度を1024×1024としています。現行のHugging Face Diffusers SDXLガイドも、最良の結果を得る既定値として1024×1024を案内しています。768×768と512×512も設定できますが、512×512未満は推奨されていません。正方形しか出せないという意味ではなく、SDXLは複数のアスペクト比を扱うよう学習されています。
| 確認項目 | 公式情報から分かること | 実務上の読み方 |
|---|---|---|
| 公開日 | 2023年7月26日 | 2026年の新モデルではなく、成熟した旧世代モデルとして評価する |
| 基本出力 | 1024×1024 | 小さく生成して後から拡大する前提ではなく、最初から1024px級を基準にする |
| テキスト処理 | 2つの固定済みテキストエンコーダー | プロンプトの解釈経路が従来版から拡張されている |
| 生成経路 | Base単体、またはBase+Refiner | Refinerは必須ではなく、品質と計算資源で使い分ける |
- テキスト入力:生成したい内容をプロンプトで指定
- 2つのテキストエンコーダー:テキスト条件を画像生成へ渡す
- Baseモデル:ノイズを含む潜在表現から全体を生成
- Refinerモデル(任意):低ノイズ段階を引き継いで細部を整える
- 画像出力:1024×1024を基本に、用途に合う比率で保存
「文字が得意」は相対評価として読む
2023年の公式発表は、旧世代より手や文字、空間配置の難しい概念を改善したと説明しました。一方、現在のSDXL 1.0 Baseモデルカードは、判読可能な文字を安定して描けないこと、複雑な位置関係、顔や人物に失敗し得ることを制限として明記しています。したがって「以前より改善した」と「業務で正確に再現できる」は別です。ロゴ、価格、注意書きなど正確さが必要な文字は、生成後にデザインツールで組む方が安全です。
BaseとRefinerはどう役割を分けるのか
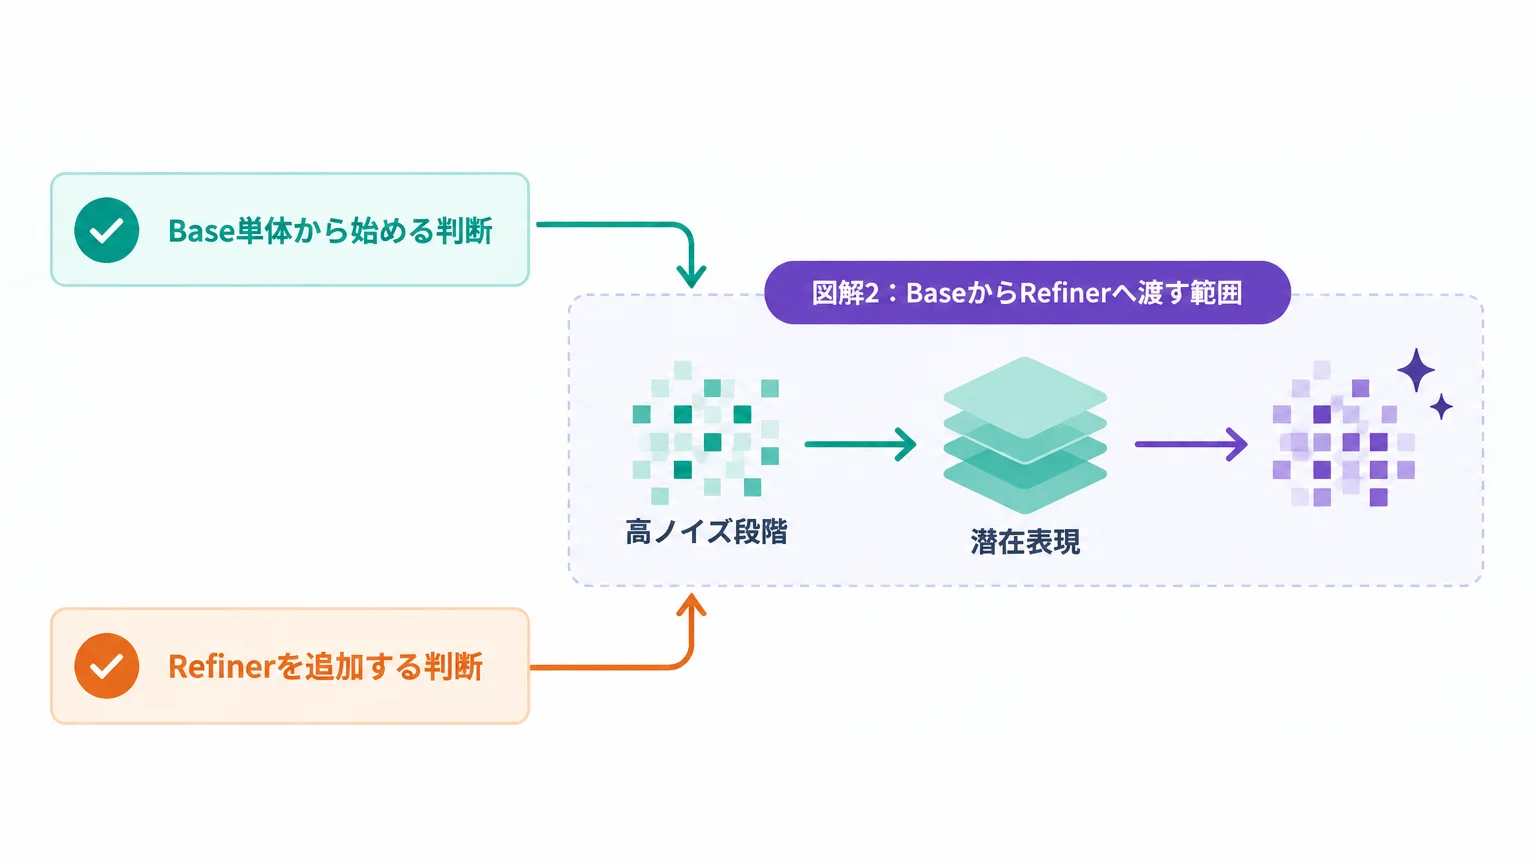
SDXLを理解する鍵は、BaseとRefinerを常にセットだと思い込まないことです。公式モデルカードでは、Baseがノイズの多い段階から潜在表現を作り、Refinerが最終の低ノイズ段階を担当します。同時に、Baseは単体でも利用できると明記されています。
Baseモデルが構図、主要要素、全体の方向を形成
画像へ復号する前の状態で次工程へ渡す
Refinerモデルが最終のデノイズを担当
用途に合わせて確認し、必要なら人が修正
Base単体から始める判断
多数の案を出したい、GPUメモリを抑えたい、まずプロンプトと構図を固めたい場合は、Base単体が合理的です。2モデルを読み込むBase+Refinerは、Base単体よりメモリと処理を必要とします。公式技術報告も、2モデル構成にはメモリと生成速度の負担があると説明しています。
Refinerを追加する判断
最終候補の細部を詰めたい場合はRefinerを試せます。公式モデルカードの2023年評価では、Base単体よりBase+Refinerの方が全体の選好評価で良い結果でした。ただし、これは当時の評価条件に基づく結果で、あらゆる派生チェックポイントや業務素材での品質保証ではありません。代表プロンプトを固定し、Base単体と同じシード・条件で比較してから採用してください。
2026年9月26日時点でSDXLは現役か
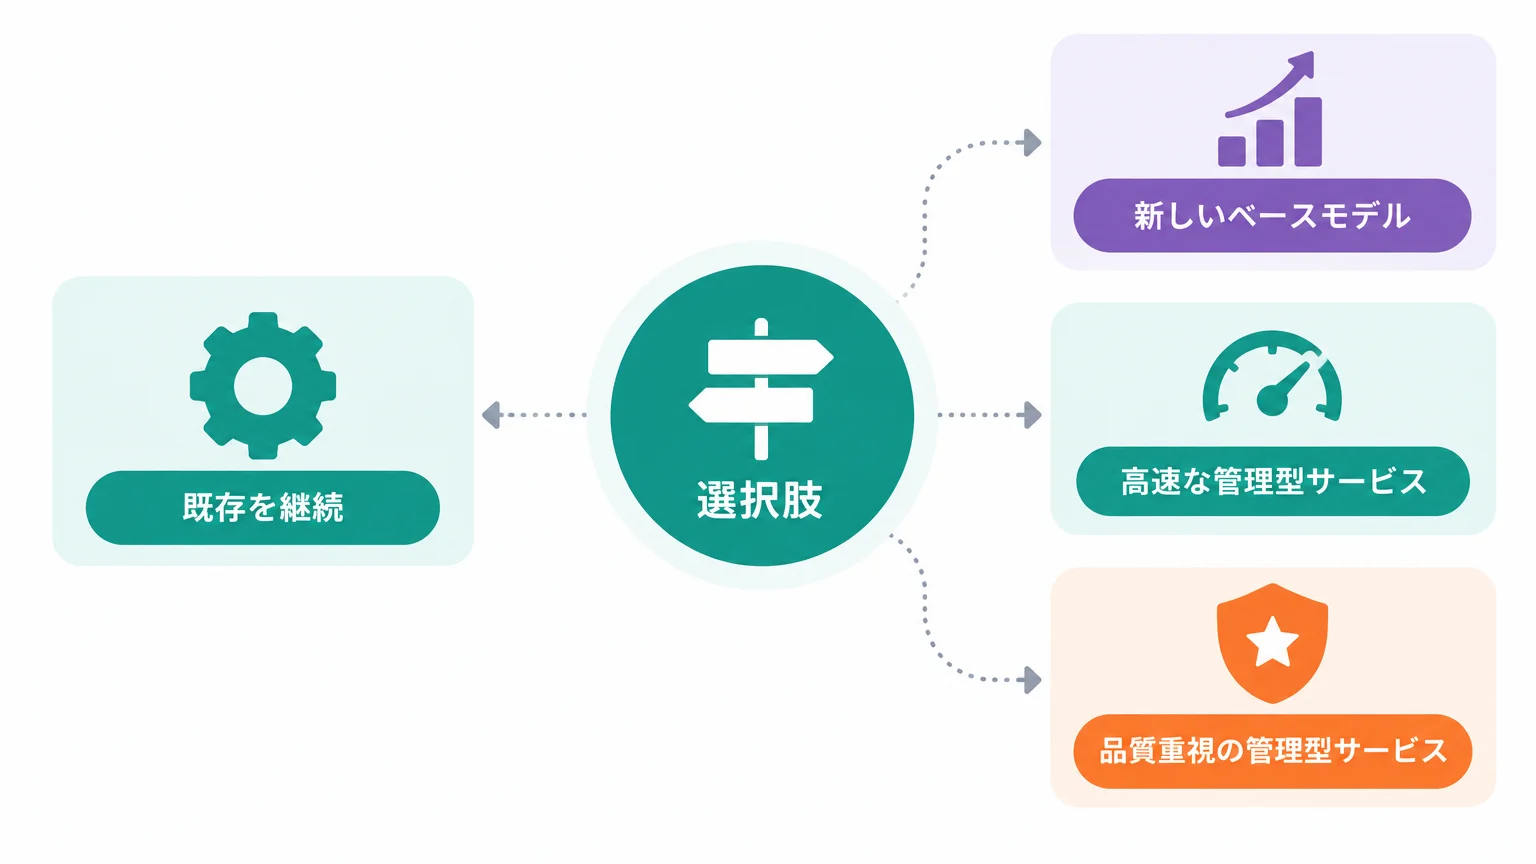
答えは「利用可能だが、Stability AIの最新系統ではない」です。公式Hugging FaceではBase 1.0とRefiner 1.0が公開されたままで、公式APIの現行ラインアップにもSDXL 1.0があります。一方、Stability AIの現行価格・モデル一覧はSDXL 1.0を「straightforward image generation向けのlegacy base model」と表記しています。
2026年9月12日から9月26日までのStability AI公式ニュースと公式Hugging Face更新も確認しましたが、SDXL 1.0本体の位置づけを変える発表は確認できませんでした。現行の整理は、Stable Image CoreがSDXLに続く管理型サービス、Stable Diffusion 3.5が最新のベースモデル系統、Stable Image UltraがSD3.5 Largeを基盤とする管理型の旗艦サービスです。
| 選択肢 | 2026年9月26日時点の公式な位置づけ | 主な利用経路 | 選ぶ判断 |
|---|---|---|---|
| SDXL 1.0 | 旧世代のベースモデル | 公式Hugging Face、Stability API | 既存のSDXL構成を維持したい、CreativeML Open RAIL++-Mの条件でセルフホストしたい |
| Stable Image Core | SDXLに続く高速・コスト重視の管理型サービス | Stability APIなど | モデル運用より、APIでの素早い案出しを優先する |
| Stable Diffusion 3.5 | 最新のダウンロード可能なベースモデル系統 | 公式Hugging Face、Stability APIなど | 新しいベースモデルを調整・セルフホストしたい |
| Stable Image Ultra | SD3.5 Largeを基盤とする管理型の旗艦サービス | Stability APIなど | 管理型サービスで品質と複雑な構図を優先する |
この4つは同じ種類の商品ではありません。ダウンロードできるモデル重みと、APIで提供される管理型サービスを同列に「後継モデル」と呼ぶと、ライセンスと運用責任を取り違えます。詳細はStable Diffusion 3.5公式発表とStability AI API公式リファレンスで確認できます。
SDXL 1.0
Base単体/Base+Refiner
Stable Diffusion 3.5
重みを取得して調整・運用
Stable Image Core
API中心で案出し
Stable Image Ultra
SD3.5 Largeを基盤
Stability AI以外も含めた最新の画像生成APIを比較したい方は、AIgent Labのgpt-image-2.5 APIの料金と移行手順も参照してください。API型とセルフホスト型では、モデル品質だけでなく、データの扱い、再現性、保守工数が変わります。
公式手順だけでSDXLを動かすには
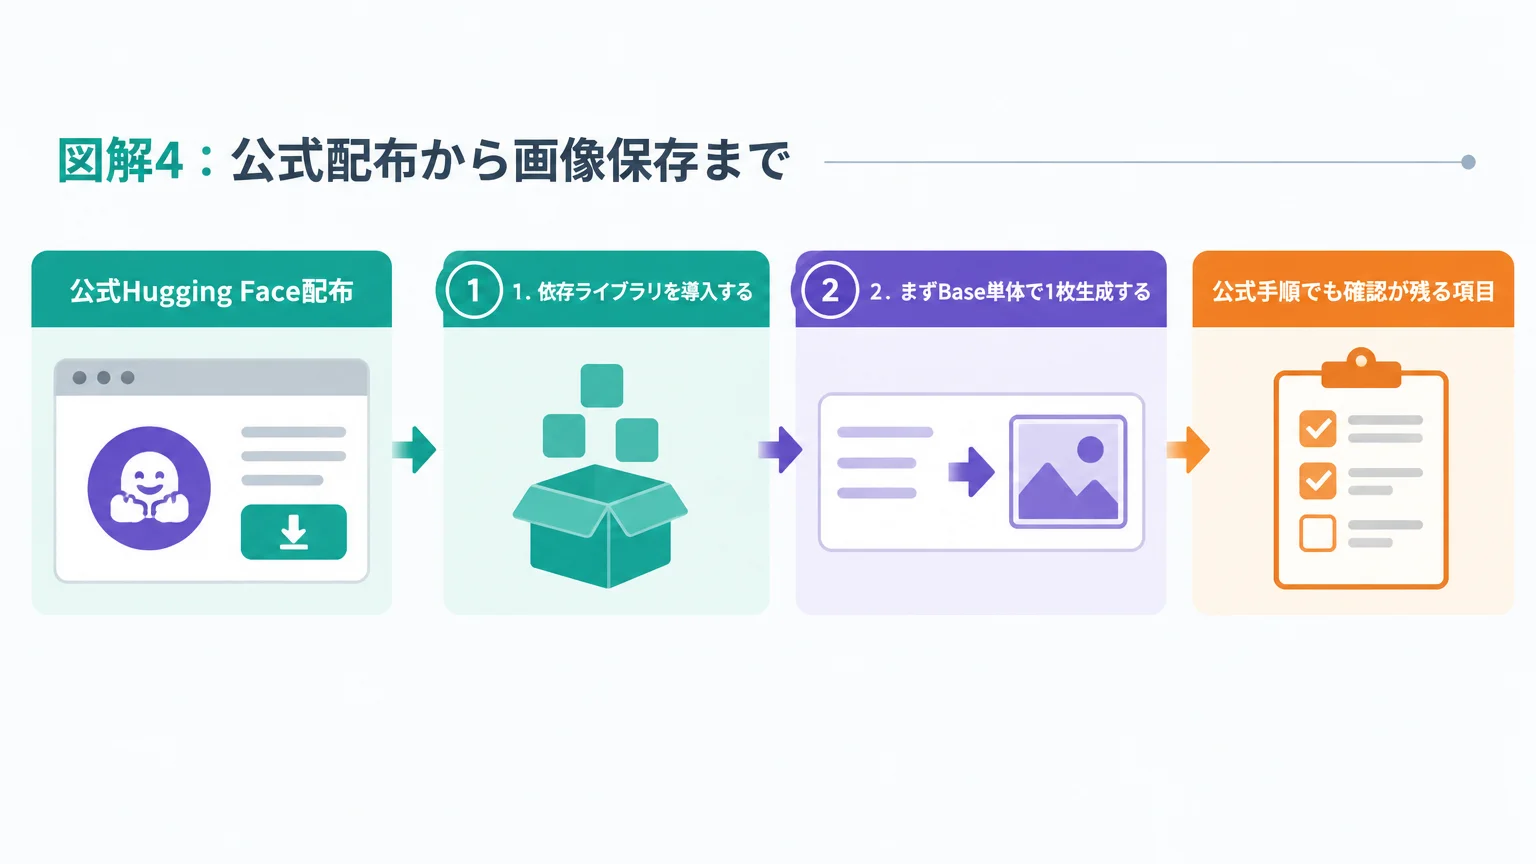
ここでは、2026年9月26日に取得した公式Hugging FaceモデルカードとDiffusersガイドの方法だけを使います。第三者Web UIの拡張機能や非公式配布ファイルは対象外です。想定環境は、PythonとPyTorchが利用できる環境、CUDA対応GPU、公式モデルを取得できるネットワークです。Stability AIは2023年の発表で8GB VRAMのコンシューマーGPUでも効果的に動作するとの目安を示しましたが、これは全構成の保証された最低要件ではありません。
- 公式Hugging Face配布:Base 1.0とRefiner 1.0のモデルカードを確認
- Diffusers:公式が案内する依存ライブラリを導入
- Base単体:1024×1024で最初の出力を確認
- Base+Refiner:必要な候補だけ低ノイズ段階を引き継ぐ
- 出力レビュー:文字、人物、構図、権利、用途適合性を人が確認
1.依存ライブラリを導入する
公式ガイドが案内するDiffusers、Transformers、Accelerate、Safetensors、Invisible Watermarkを導入します。既存環境を壊さないよう、仮想環境で実行してください。
python -m pip install -U diffusers transformers accelerate safetensors "invisible-watermark>=0.2.0"注意:本番環境で使用する前に、必ずテスト環境で動作確認してください。パッケージを更新する前に、利用中のPyTorchとCUDAの組み合わせも確認します。
2.まずBase単体で1枚生成する
現行Diffusers APIが受け付けるクラスと読み込み引数で組んだ最小例です。公式ドキュメントのモデルIDと読み込み設定を使い、プロンプトは業務ラフ向けにしています。非公式チェックポイントは混ぜていません。
import torch
from diffusers import StableDiffusionXLPipeline

pipe = StableDiffusionXLPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
).to("cuda")

prompt = "studio product photo of a reusable bottle on a white pedestal"
image = pipe(prompt=prompt, height=1024, width=1024).images[0]
image.save("sdxl-base.png")ポイント:stabilityai/stable-diffusion-xl-base-1.0が公式モデルIDです。1024×1024は公式ガイドの既定です。GPUメモリが不足する場合、公式モデルカードは.to("cuda")の代わりにenable_model_cpu_offload()を使う方法を案内しています。ただし、実行速度や必要メモリは環境によって変わるため、ここでは数値を断定しません。
3.必要な候補だけBase+Refinerで仕上げる
次は公式モデルカードの2段階例です。Baseのtext_encoder_2とvaeをRefinerで共有し、Baseの結果を画像ではなく潜在表現のまま渡します。40ステップと0.8の分割は公式サンプル値であり、SDXLの固定仕様ではありません。
import torch
from diffusers import DiffusionPipeline

base = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
).to("cuda")

refiner = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-refiner-1.0",
    text_encoder_2=base.text_encoder_2,
    vae=base.vae,
    dtype=torch.float16,
    variant="fp16",
    use_safetensors=True,
).to("cuda")

prompt = "studio product photo of a reusable bottle on a white pedestal"
steps = 40
switch = 0.8

latents = base(
    prompt=prompt,
    num_inference_steps=steps,
    denoising_end=switch,
    output_type="latent",
).images

image = refiner(
    prompt=prompt,
    num_inference_steps=steps,
    denoising_start=switch,
    image=latents,
).images[0]

image.save("sdxl-base-refiner.png")注意:本番環境で使用する前に、必ずテスト環境で動作確認してください。ライブラリの更新で引数や推奨方法が変わる可能性があるため、再現性が必要な案件では動作確認後のバージョンをロックファイルへ記録します。
公式手順でも確認が残る項目
- 同じプロンプトとシードでBase単体とBase+Refinerを比較する
- 人物、文字、ロゴ、細かな位置関係を目視する
- 入力素材に社外秘・個人情報・未許諾素材を含めない
- 採用したモデルID、リビジョン、依存ライブラリ、生成条件を記録する
- 公開前に人が用途適合性と第三者権利を確認する
SDXLは商用利用できるのか
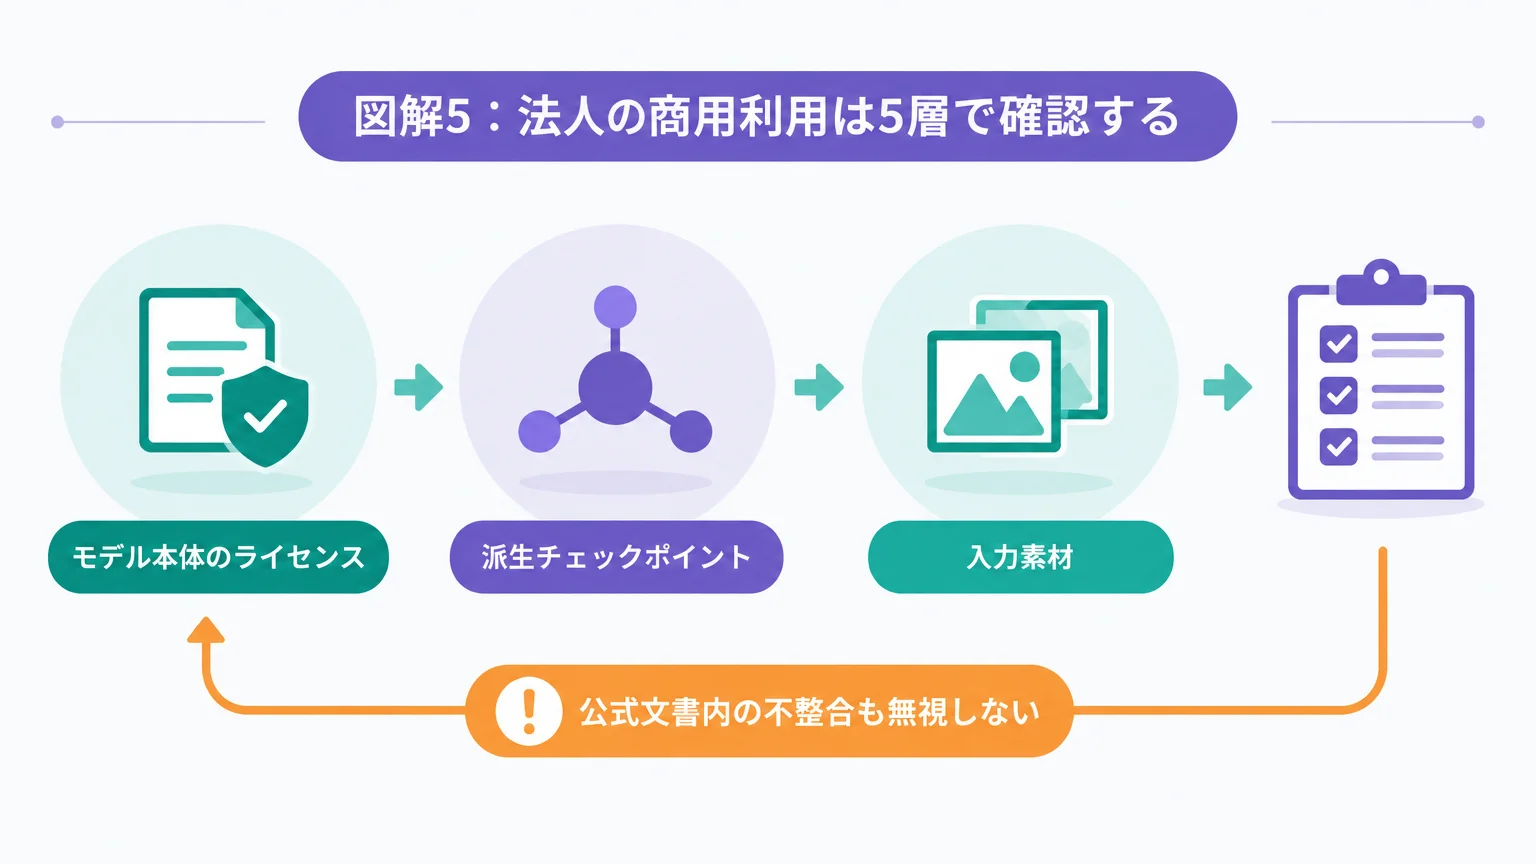
「条件付きで候補にできる」が正確な答えです。SDXL 1.0 BaseとRefinerにはCreativeML Open RAIL++-M Licenseが適用されています。ライセンス本文は、条件に従う限り、モデルや派生モデルの複製、改変、配布、SaaS提供などを認めています。そのため、商用利用を一律に禁止するライセンスではありません。
ただし「商用利用可」を「無条件で自由」と読み替えてはいけません。用途制限があり、モデルや派生モデルを再配布したりAPIとして第三者へ提供したりする場合には、用途制限の継承、ライセンスの提供、変更表示、帰属表示の保持などが必要です。生成物についてStability AIが権利を主張しないことと、第三者の著作権、商標権、肖像権、パブリシティ権が自動的に処理されることも別問題です。
公式文書内の不整合も無視しない
法人利用で特に注意したいのは、CreativeML Open RAIL++-Mの広い権利許諾と、同じ公式モデルカードの「研究目的向け」というDirect Use記載が並存している点です。この記事は一方だけを根拠に「自由に商用利用できる」と断定しません。利用形態、配布の有無、派生モデル、契約相手、地域の法令を整理し、判断が必要な案件は法務担当者へ確認してください。
SD3.5の年間売上条件をSDXL 1.0へ流用しない
Stable Diffusion 3.5 Large、Large Turbo、Mediumは別のStability AI Community Licenseです。契約本文は、年間売上100万米ドル未満の組織に無料の限定的な商用利用を認める一方、商用利用者にはStability AIへの登録を求めています。売上はモデル由来かどうかを問わず本人と関連会社を合算し、100万米ドルを超えた場合は同契約上のライセンスが終了して別ライセンスの申請が必要です。通常のSDXL 1.0 Base/RefinerはCreativeML Open RAIL++-Mであり、この売上条件や登録義務を流用しません。似たブランド名でもライセンスが違うため、「Stability AIのモデルはすべて同じ条件」とまとめないでください。ちょうど境界額に達した場合を含む扱いは、Community License Agreementの現行本文を個別に確認します。
- モデル本体のライセンス:SDXL 1.0はCreativeML Open RAIL++-M
- 派生チェックポイント:配布ページの個別条件と用途制限
- 入力素材:著作権、商標、肖像、個人情報、社外秘
- 生成物:人のレビュー、類似性、表示内容、利用媒体
- 利用サービス規約:API、クラウド、UI提供者の最新条件
なお、Stability AIの利用ルールはモデルライセンスだけでは完結しません。2026年9月26日時点で有効なAcceptable Use Policyも確認し、利用開始時と公開前に更新の有無を見直してください。ここでの説明は一般的な情報整理であり、個別案件への法的助言ではありません。
法人で使うなら、どの工程に置くか
事例区分:想定シナリオ/構成例
SDXLは、成果物を無審査で公開する自動化より、人が選び直せる制作工程の前半へ置くと管理しやすくなります。以下は実在企業の成果ではなく、公式仕様と制限を踏まえた構成例です。
| 業務 | SDXLを置く場所 | 人が確認すること |
|---|---|---|
| 広告・キャンペーン | 構図案、背景案、ムードボード | 商品表現、文字、ブランドガイド、類似性 |
| 商品企画 | パッケージや利用シーンのラフ | 実物との差、誤認表示、商標、法定表示 |
| 社内資料 | 説明用イメージ、概念ビジュアル | 事実とイメージの区別、人物・組織の誤認 |
| ゲーム・映像 | 世界観探索、背景・小物の初期案 | 既存作品との類似、最終素材の権利処理 |
| 研究開発 | セルフホスト構成や画像ワークフローの試作 | モデル版、入力データ、ログ、禁止用途 |
セルフホストの価値は「無料」だけではない
モデル重みを自社環境で動かせると、生成条件やリビジョンを固定しやすくなります。ただし、GPU費用、脆弱性対応、アクセス制御、監査ログ、モデル更新は自社の責任です。ローカル実行の考え方をLLM運用と比較したい場合は、AIgent LabのOllamaでローカルLLMを動かすガイドも参考になります。画像モデルとLLMでは技術要素が違いますが、データ持ち出し、権限、バージョン固定、監査という運用論点は共通します。
公開工程には人の停止線を置く
SDXLの公式モデルカードは、完全な写実性、判読可能な文字、複雑な構図、顔や人物に限界があると明記しています。したがって、価格や効能を含む広告、実在人物に見える画像、正確な図面、報道写真のように受け取られる画像を、そのまま自動公開する運用には向きません。生成と公開を分け、権利確認と内容確認を通った画像だけを採用してください。
導入でつまずく4つの誤解
誤解1:SDXLはStable Diffusionの最新版である
❌ 誤り:2026年もSDXLを「Stability AIの最新モデル」と紹介する。
⭕ 修正:SDXL 1.0は利用可能な旧世代ベースモデルと説明し、最新ベース系統のSD3.5、管理型のStable Image Core/Ultraも比較します。
なぜ重要か:世代を誤ると、品質だけでなく、ライセンスと提供形態まで誤って選定するからです。
誤解2:Refinerは常に必須である
❌ 誤り:全画像をBase+Refinerで処理しないとSDXLではない。
⭕ 修正:公式モデルカードどおりBase単体から始め、細部を比較する価値がある候補だけRefinerへ渡します。
なぜ重要か:2モデル構成はメモリと処理を追加で使います。用途によってはBase単体で意思決定できます。
誤解3:CreativeML Open RAIL++-Mなら何にでも商用利用できる
❌ 誤り:商用利用という言葉だけを確認し、禁止用途、再配布条件、派生モデル、入力素材、第三者権利を見ない。
⭕ 修正:モデル本体、派生チェックポイント、入力素材、生成物、利用サービス規約の5層で確認します。
なぜ重要か:Stability AIが生成物へ権利を主張しないことは、他者の権利を侵害しない保証ではありません。
誤解4:1024×1024なら文字や人物も正確である
❌ 誤り:解像度が上がれば、文字、指、人物、位置関係も正確になると考える。
⭕ 修正:解像度と意味の正確さを分け、重要箇所を拡大して人が確認します。文字は後工程で組みます。
なぜ重要か:公式モデルカード自身が、判読可能な文字、複雑な構図、顔や人物の限界を明記しているからです。
SDXLに関するよくある質問
SDXLとは何ですか?
Stability AIが2023年7月26日に公開した、テキストから画像を生成・変更する潜在拡散モデルです。Base単体で使え、必要に応じてRefinerを追加できます。
SDXLは無料で使えますか?
公式Hugging FaceのBase/Refiner重みは取得できますが、実行するGPU、クラウド、ストレージ、保守には費用がかかります。Stability APIを使う場合は別途API料金があり、2026年9月26日時点の公式APIリファレンスでは、SDXL 1.0は30ステップ以下の生成が0.9クレジット、30ステップを超える場合は0.9 ×(steps ÷ 30)クレジットです。公式価格表では1クレジットを0.01米ドルと案内しています。価格は変更され得るため、利用時に公式表を再確認してください。
SDXLで作った画像は商用利用できますか?
SDXL 1.0のCreativeML Open RAIL++-Mは商用利用を一律禁止していませんが、禁止用途と再配布条件があります。派生モデルの個別ライセンス、入力素材、第三者権利、利用サービス規約も別に確認してください。「生成物の権利が必ず利用者へ帰属する」とは断定できません。
SDXLの最低スペックはどれくらいですか?
2023年7月のStability AI公式発表は、8GB VRAMのコンシューマーGPUで効果的に動作するとの目安を示しています。ただし保証された最低要件ではなく、Base+Refinerの同時利用、精度、ライブラリ、CPUオフロードで必要量は変わります。購入判断は実際の構成で検証してください。
Refinerは使わなくてもよいですか?
はい。公式モデルカードはBase単体で使えると明記しています。まずBaseで構図と用途適合性を確認し、細部の改善が必要な候補だけRefinerと比較する方法が分かりやすいです。
日本語プロンプトに対応していますか?
2026年9月26日時点のSDXL 1.0公式モデルカードとDiffusers手順は英語例を中心にしており、日本語品質を保証する記載は確認できません。日本語を使う場合は、業務で使う代表入力を固定し、英語版と比較してください。Stability AIのCore Models一覧にある「Japanese SDXL」は通常のSDXL 1.0 Baseとは別モデルです。
Stable Diffusion 1.5と何が違いますか?
SDXLはネイティブ1024×1024、約3倍大きいUNet、2つのテキストエンコーダー、サイズ・切り抜き条件、任意のRefinerを導入しています。単なる解像度変更ではなく、モデル構造と学習条件が異なります。
SDXL Turboとは同じモデルですか?
同じではありません。SDXL Turbo公式発表によると、SDXL TurboはSDXL 1.0を基に蒸留し、1〜4ステップの高速生成を狙った別モデルです。通常のSDXL 1.0とライセンス条件も同一とは限らないため、現在のCore Models一覧と適用契約を確認してください。
新規導入ならSD3.5へ移るべきですか?
自動的に移るべきとは言えません。新しいベースモデルを調整したいならSD3.5、既存のSDXLワークフローを維持したいならSDXL、API運用を優先するならStable Image CoreまたはUltraが候補です。同じ入力、出力条件、レビュー基準、ライセンス、運用費で小規模に比較して決めてください。
運営元 Uravation よりAIエージェントを構想から本番運用まで進める順番と、体制・KPIの決め方をまとめた資料を無料で公開しています。 AIエージェント導入ロードマップを受け取る(無料)
参考・出典
- Announcing SDXL 1.0 — Stability AI、2023年7月26日公開(参照日: 2026年9月26日)
- SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis — Stability AI Research、2023年7月4日初回提出(参照日: 2026年9月26日)
- SD-XL 1.0 Base Model Card — Stability AI / Hugging Face(参照日: 2026年9月26日)
- SD-XL 1.0 Refiner Model Card — Stability AI / Hugging Face(参照日: 2026年9月26日)
- Stable Diffusion XL Guide — Hugging Face Diffusers(参照日: 2026年9月26日)
- CreativeML Open RAIL++-M License — Stability AI、2023年7月26日付(参照日: 2026年9月26日)
- Introducing Stable Diffusion 3.5 — Stability AI、2024年10月22日公開・10月29日更新(参照日: 2026年9月26日)
- Stability AI REST API — Stability AI(参照日: 2026年9月26日)
- Stability AI API Pricing — Stability AI(参照日: 2026年9月26日)
- Stability AI Core Models — Stability AI、2026年5月20日更新(参照日: 2026年9月26日)
結論と次の一歩
SDXLとは、Base単体でも動き、必要に応じてRefinerを追加できる1024px級の画像生成モデルです。2026年9月26日時点で利用は続けられますが、公式上は旧世代です。新規導入では「SDXLを使えるか」だけでなく、「既存資産を維持するのか」「新しいベースモデルをセルフホストするのか」「管理型APIへ寄せるのか」を先に決めると迷いにくくなります。
- 既存資産を棚卸しする:モデルID、派生チェックポイント、ワークフロー、入力素材、公開先を一覧にします。
- 候補を同じ条件で比べる:SDXL Base、必要ならRefiner、SD3.5またはStable Imageサービスを、同じ代表入力とレビュー項目で比較します。
- 公開前の停止線を決める:文字、人物、権利、ブランド、事実性を人が確認し、採用条件を満たさない画像は公開しません。
この記事を読んで導入イメージが固まってきた方へ
UravationではAIエージェント導入の研修・コンサルを行っています。
この記事はAIgent Lab編集部がお届けしました。